

 로그인을 해주세요

안녕하세요.
투썬AI스쿨입니다.
흥미로운 주제, '언어모델 활용법'의
'퓨샷 프롬팅(Few-shot Prompting)'에 대해 이야기하려고 합니다.
인공지능은 이제 우리 삶의 많은 부분에서 활용되고 있으며,
특히 언어 모델은 기계 번역부터 텍스트 분석, 챗봇 개발까지
다양한 분야에서 활용되고 있습니다.
'퓨샷 프롬팅' 기법은 인공지능 언어 모델이 어떻게 학습하는지,
그 결과를 우리가 원하는 방향으로 유도할 수 있는지를 이해하는 데 큰 도움이 됩니다!
퓨샷 프롬팅은 어떻게 언어 모델의 성능을 향상시킬 수 있는지
함께 알아볼까요?
few-shot Prompting
먼저 제로샷 프롬팅(Zero-shot Prompting)에 대해 알아보도록 하겠습니다.
제로샷 프롬팅은 큰 언어모델,
예를 들어 GPT-3 같은 모델이 "예시 없이" 어떤 작업을 수행하는 능력을 의미합니다.
이런 모델들은 대량의 데이터에 대해 학습하며,
지시사항을 따르는 방법을 터득합니다.
따라서 아무런 예시를 제공하지 않아도 특정 작업을 수행할 수 있는 능력이 있습니다.
이를 '제로샷' 능력이라고 부릅니다.
예를 들어, 우리가 모델에게 다음과 같은 작업을 지시한다고 생각해봅시다.
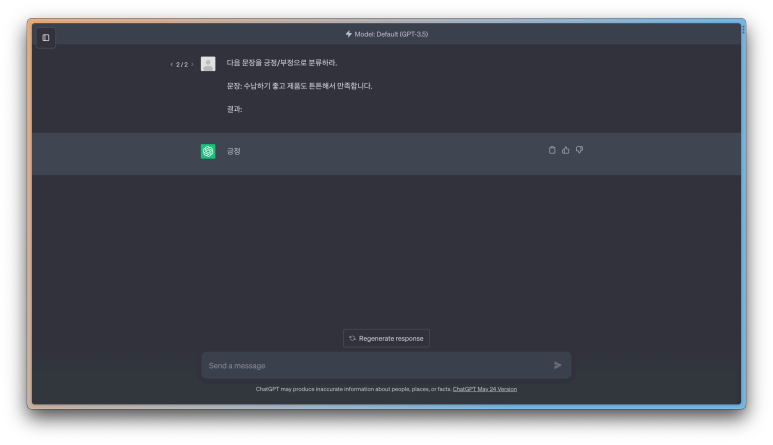
위의 지시사항에서 모델에게 텍스트와 해당 분류에 대한 예시를 제공하지 않았음에도,
모델은 '감정'을 이해하고 텍스트를 적절하게 분류하였습니다.
이것이 바로 제로 샷 능력의 힘입니다.
이와 같은 제로샷 학습을 향상시키는 방법으로는 '명령어 튜닝(Instruction Tuning)'이 있습니다.
명령어 튜닝이란, 데이터셋에 대한 설명을 통해 모델을 미세조정하는 개념입니다.
또한, 'RLHF(Reinforcement Learning from Human Feedback)'이라는 방법이
이를 확장하여 사용되어, 모델이 사람의 선호도에 더 잘 맞게 조정됩니다.
이런 최신의 발전이 바로 ChatGPT와 같은 모델들을 구동하는 기술입니다.
이 방법들은 앞으로 더 자세하게 살펴볼 예정입니다.
하지만 제로샷 방식이 작동하지 않는 경우도 있습니다.
이럴 때는 '프롬프트'에 예시나 설명을 제공하여,
'퓨샷 프롬팅'으로 이동하는 것이 좋습니다.
퓨샷 프롬팅이란 제로 샷 프롬팅이 충분히 작동하지 않는
복잡한 작업에 대해 적용할 수 있는 기법입니다.
이 방법은 '프롬프트' 안에 데모나 예시를 제공함으로써
모델의 성능을 향상시키는 데 도움을 줍니다.
이런 예시들은 모델이 더 나은 반응을 생성하게 하기 위한 조건이 됩니다.
이는 특히 파리 미터가 많은 언어 모델에서 잘 작동합니다.
다음은 1개의 예시를 준 one-shot prompting의 예시입니다.
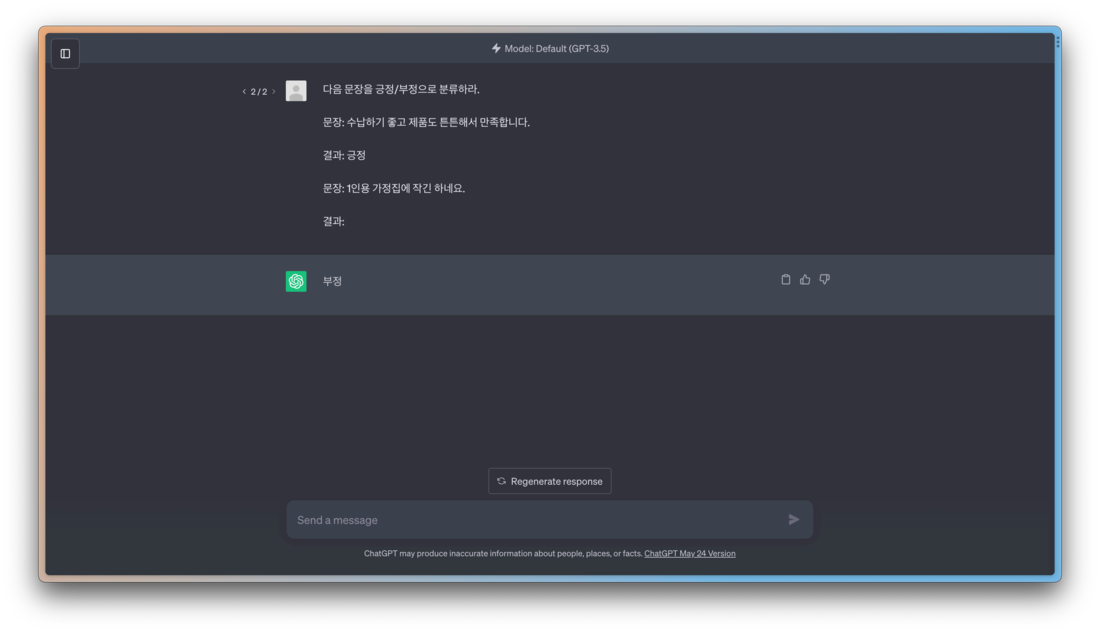
문장의 긍정/부정을 판단하는 작업을 위와 같이
하나의 예시를 주면서 원하는 결과의 형태로
언어 모델이 응답을 하는 것을 확인할 수 있습니다.
하나 이상의 예시를 주면, 준 예시의 수 (n) 만큼
n-shot 프롬프팅이라고 부릅니다.
n-shot prompting을 묶어서 few-shot prompting 이라고 부릅니다.
아래는 2-shot prompting 의 예시입니다.
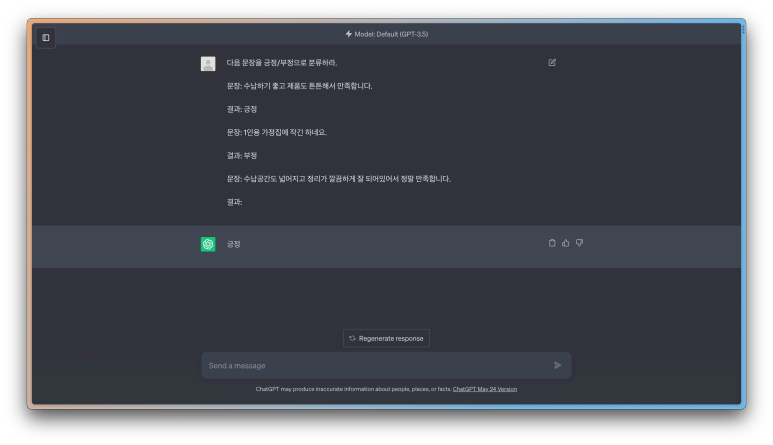
few-shot prompting의 재미있는 부분은
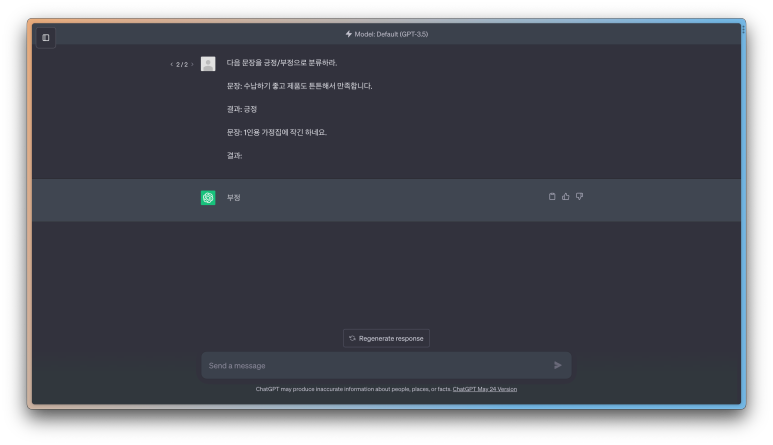
아래와 같이 틀린 예시를 주더라도
언어모델의 응답은 정확할 수 있다는 것입니다.
예를들면, 위에서 긍정/부정 분류가 틀린 예를 주어도
언어모델은 "수납공간도 넓어지고 정리가 깔끔하게 잘 되어있어서 만족합니다." 라는 문장을
"긍정"으로 잘 분류해내는 것을 확인할 수 있습니다.
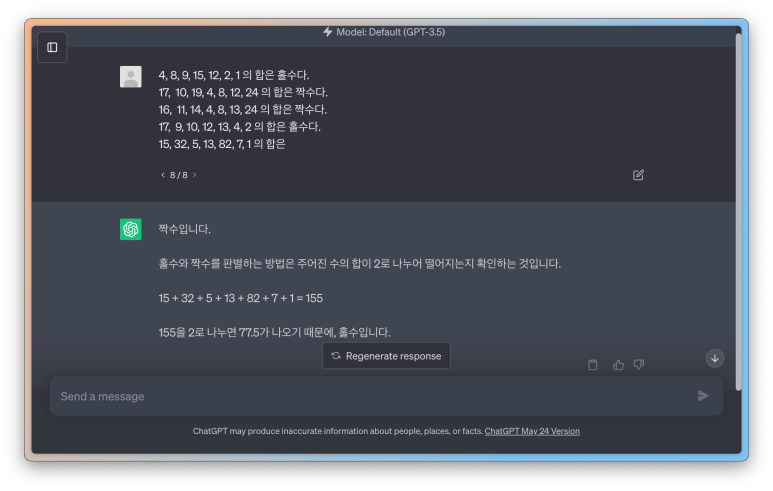
그러나 few-shot prompting 만으로 해결하기 어려운 경우도 있습니다.
특히 논리, 수학적인 영역과 같이 추론 능력이 필요한 작업들은
언어모델을 통해 정확한 답을 유도해내는 것이 어렵습니다.
따라서 이와 같은 작업을 언어모델에게 줄 때는 다른 접근이 필요합니다.
아래는 언어모델이 혼란을 겪는 예시입니다.
퓨샷 프롬팅(Few-shot Prompting)에 대해
자세히 이해하셨나요?
혹시 궁금한 점이 있으시다면,
aischool@twosun.com으로
메일부탁드립니다.
다음 게시글에서는
CoT(Chain-of-Thought) Prompting에 대해
자세히 알아보겠습니다.
감사합니다.
 첨부파일


)